
Votre extension SEO vous propose un nouveau réglage, « llms.txt », avec un joli interrupteur. Un consultant vous jure que c’est le robots.txt de l’IA. Un autre que c’est inutile. Et vous, vous voulez juste savoir s’il faut cliquer ou non. 😅
La réponse courte : non, le llms.txt n’est pas un levier SEO, et oui, vous pouvez en avoir un si cela ne vous coûte qu’un clic. Le reste de ce guide vous donne les preuves : ce qu’en disent Google et les éditeurs d’IA, ce que mesurent les études de logs, qui en publie vraiment (nous avons vérifié 36 sites), et les pièges de la génération automatique.
Faut-il créer un fichier llms.txt ? La réponse courte ✅
Le bon côté : c’est gratuit, rapide, sans risque pour votre référencement Google. Là où ça coince : aucun bénéfice de visibilité prouvé, et un fichier qui, généré sans relecture, peut donner une mauvaise image de votre site aux rares agents qui le lisent.
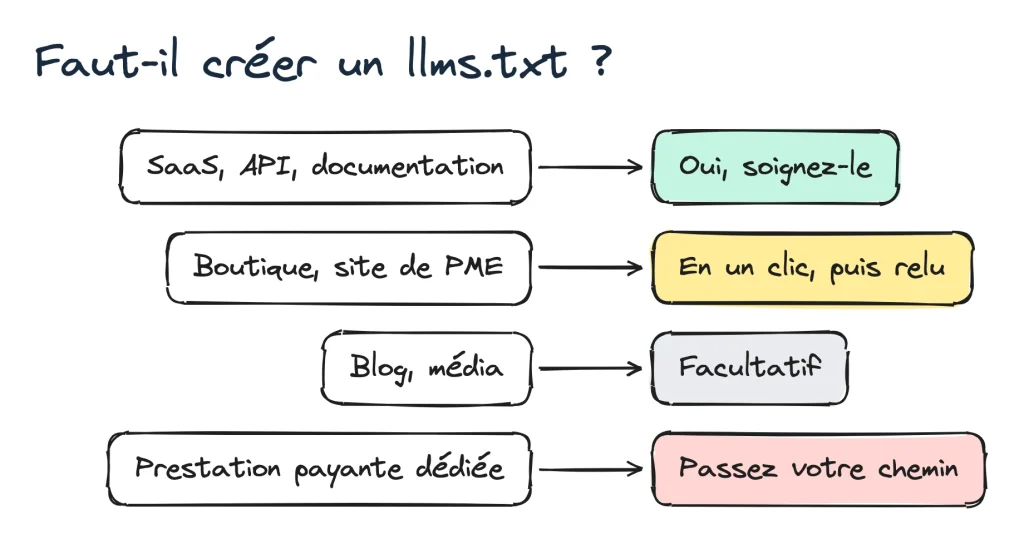
- Vous éditez un SaaS, une API ou une documentation technique : oui, sans hésiter. C’est le cas d’usage pour lequel le fichier a été pensé, et les agents de code sont justement ceux qui le lisent le plus selon Ahrefs. Ajoutez des versions Markdown de vos pages clés.
- Vous avez un e-commerce ou un site de PME sous WordPress : pourquoi pas, si votre extension SEO le fait en un clic. Mais relisez ce qu’il contient : la version générée en un clic peut oublier des types de pages entiers et recopier les accroches de vos articles. N’y passez pas une journée pour autant.
- Vous tenez un blog ou un média : facultatif. Votre énergie sera mieux placée dans les leviers qui comptent vraiment pour les IA : contenu unique, sources, structure, robots.txt bien réglé (tout est dans notre guide du GEO).
- Un prestataire vous facture un « llms.txt optimisé pour ChatGPT » : passez votre chemin. Rien ne permet aujourd’hui de promettre un effet sur les citations.
Le llms.txt, c’est quoi exactement ? 🤔
Imaginez un grand centre commercial. Les humains se débrouillent avec les vitrines et les panneaux. Un visiteur pressé, lui, cherche le plan « Vous êtes ici » à l’entrée. Le llms.txt veut être ce plan, mais pour les modèles de langage (LLM) et les agents IA.
L’idée vient de Jeremy Howard, cofondateur d’Answer.AI et de fast.ai, qui l’a proposée le 3 septembre 2024. Son constat : une page web emballe l’information dans de la navigation, de la publicité et du JavaScript. La reconvertir en texte propre est imprécis, et chaque mot inutile coûte de la place dans la « mémoire » limitée d’un modèle. D’où un fichier court, en Markdown, qui résume le site et pointe vers ses contenus essentiels.
La proposition a été révisée en version 2 en août 2026. Jeremy Howard y précise lui-même que le fichier est surtout utilisé au moment où un agent répond à une question (l’inférence), pas pour entraîner les modèles, et « le plus massivement pour la documentation logicielle ».
Deux points pour éviter les confusions :
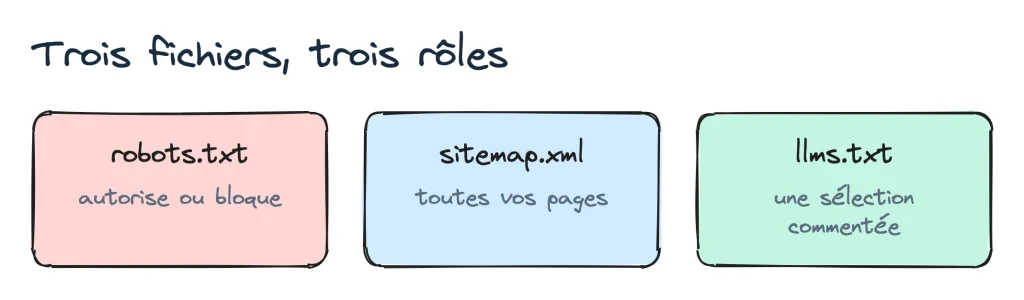
- Ce n’est pas un robots.txt. Le robots.txt dit aux robots ce qu’ils ont le droit de lire. Le llms.txt ne bloque et n’autorise rien : il oriente. Pour contrôler l’accès des robots IA, c’est toujours le robots.txt (on l’explique dans notre guide du GEO).
- Ce n’est pas un sitemap. Le sitemap liste toutes vos pages indexables. Le llms.txt est une sélection commentée, assez courte pour tenir dans le contexte d’un modèle.
À quoi ressemble un fichier llms.txt ?
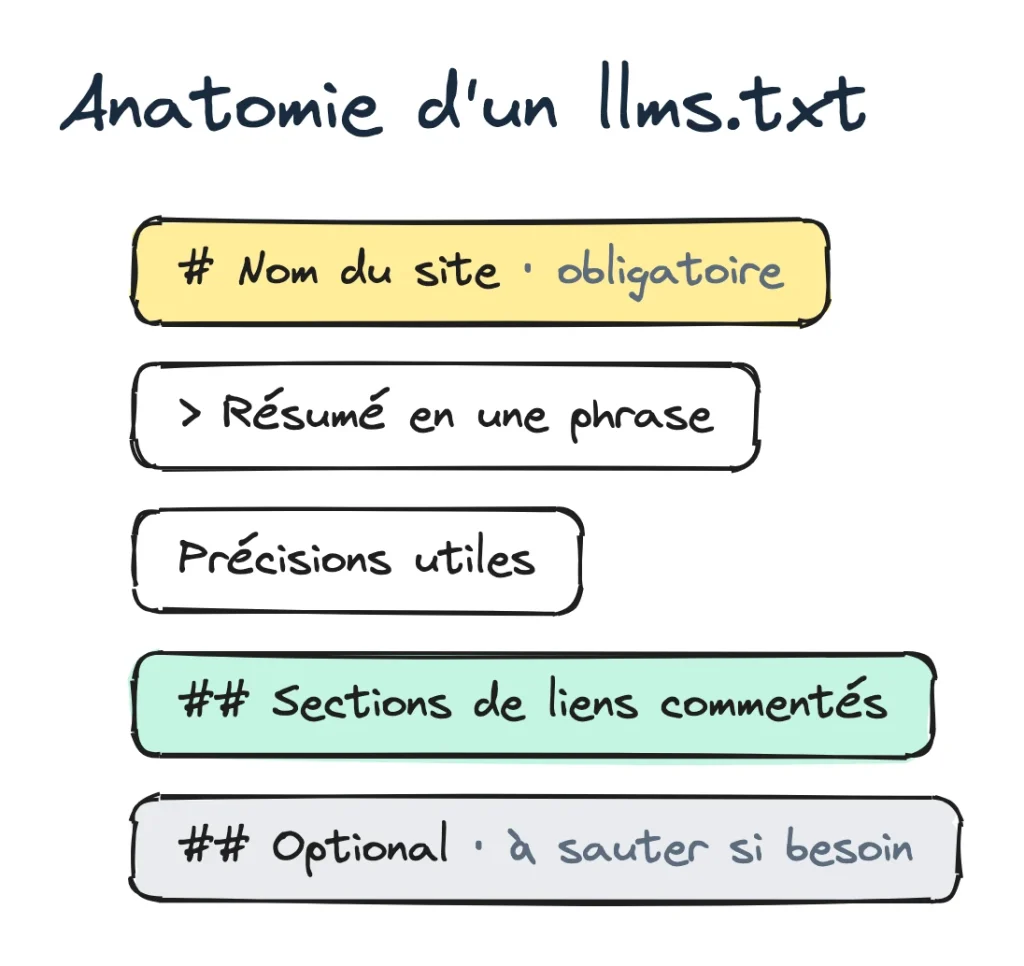
D’après la spécification, le fichier contient, dans cet ordre :
- un titre H1 avec le nom du site ou du projet (le seul élément obligatoire) ;
- une citation (
>) qui résume le site en une ou deux phrases ; - éventuellement des paragraphes ou des listes de précisions, sans titres ;
- des sections H2 contenant des listes de liens au format
nom: description; - par convention, une section « Optional » pour les liens secondaires, qu’un agent peut sauter s’il manque de place.
Voici un extrait réel, celui de Brevo, raccourci (les « […] » marquent les coupes) :
# Brevo

> Brevo is an all-in-one customer engagement platform combining email and SMS marketing, WhatsApp, marketing automation, CRM, live chat and transactional messaging. […]

Notes for AI agents: […] For pricing and plan limits, use https://www.brevo.com/pricing.md (current, per currency) rather than cached figures. […]

## Key facts

- Founded in 2012 by Armand Thiberge, in India and France ([About](https://www.brevo.com/company/about/)).
[…]

## Platform

- [Campaigns & Automation](https://www.brevo.com/products/marketing-platform/): Marketing platform for email, SMS and multichannel campaigns with automation
- [Pricing (markdown)](https://www.brevo.com/pricing.md): Machine-readable pricing for all plans in 17 currencies, with seat limits and add-ons; generated from Brevo's pricing API
[…]
Extrait du fichier brevo.com/llms.txt.
Notez le réflexe malin : Brevo renvoie les agents vers une version Markdown de sa page tarifs, plutôt que de les laisser citer des prix périmés. C’est exactement l’esprit de la proposition, qui recommande aussi de proposer une version .md des pages importantes.
Et le llms-full.txt ?
Vous croiserez aussi des fichiers llms-full.txt. Attention : ils ne font pas partie de la spécification de llmstxt.org. C’est une convention ajoutée par l’éditeur de documentation Mintlify, développée « en collaboration avec Anthropic » selon Mintlify, qui regroupe toute la documentation dans un seul fichier. Le contraste est parlant : le llms.txt d’Anthropic pèse environ 100 Ko, son llms-full.txt environ 52 Mo. Pour un site vitrine ou un blog, c’est sans intérêt.
Qui publie un llms.txt aujourd’hui ?
Surtout les acteurs dont la documentation est lue par des développeurs et leurs agents : Stripe, Cloudflare (un fichier par produit), OpenAI, Anthropic, Perplexity ou Google pour l’API Gemini. Côté marketing, on en trouve aussi chez Shopify, HubSpot, Brevo ou Yoast.
Notre relevé : 36 sites vérifiés un par un
Les études d’adoption mélangent des millions de domaines. Nous avons voulu savoir ce que font les sites que vous connaissez : 36 acteurs du marketing, du SEO, de l’e-commerce et de l’IA, interrogés à l’adresse /llms.txt. Cinq d’entre eux (dont Leboncoin, la Fnac, Le Monde et OpenAI) bloquent les requêtes automatiques : nous les avons écartés plutôt que de deviner.
| Catégorie | Ont un llms.txt | Exemples |
|---|---|---|
| Outils marketing internationaux | 10 sur 12 | HubSpot, Shopify, Semrush, Zapier, Notion, Stripe, Yoast… |
| Médias SEO français | 3 sur 4 | Abondance, WPMarmite, SeoMix |
| Outils et hébergeurs français | 1 sur 6 | Brevo (pas Haloscan, Systeme.io, o2switch, OVHcloud, PrestaShop) |
| Sites principaux des éditeurs d’IA | 1 sur 5 | Mistral (pas Anthropic, Perplexity, Google, Gemini) |
| Grands e-commerçants français | 0 sur 4 | ni Cdiscount, Decathlon, Boulanger ou Sephora |
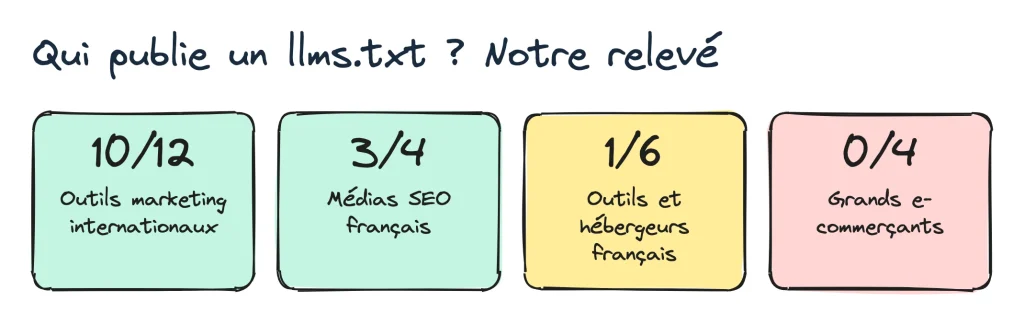
Trois enseignements :
- C’est un fichier d’éditeurs de logiciels. Les SaaS qui vendent à des développeurs et à leurs agents en ont presque tous un. Les grands e-commerçants français, aucun.
- Les éditeurs d’IA le publient pour leurs développeurs, pas pour leur site. Anthropic et Perplexity n’en ont pas sur leur site principal, mais en proposent un sur leur documentation technique. Un signe de plus que le fichier sert d’abord aux agents de code.
- Même les promoteurs ne se l’appliquent pas toujours. Rank Math, qui le génère pour ses utilisateurs, n’en publie pas sur son propre site. Ahrefs, auteur de la principale étude sur le sujet, non plus.
Côté contenu, les fichiers trouvés vont de 5 Ko (Mistral) à près de 100 Ko (Abondance, 335 liens). Celui de Mailchimp pèse plus de 500 Ko : une analyse de 990 pages qui n’a plus rien d’un plan. Les plus soignés, comme ceux de Zapier, Stripe ou Brevo, renvoient vers des versions Markdown de leurs pages, ce que recommande justement la proposition.
À plus grande échelle, les chiffres varient du simple au triple selon l’échantillon : 10,13 % des domaines étudiés par SE Ranking, 28 % chez Ahrefs, dont la clientèle est plus technique. Wix en génère d’ailleurs un pour chaque site, ce qui gonfle mécaniquement les compteurs.
Ce que disent Google, OpenAI, Anthropic et Perplexity
Soyons honnêtes deux minutes : c’est la seule question qui compte pour votre visibilité.
Google : « ni utile, ni nuisible » pour la recherche
C’est la position la plus claire du lot. Dans son guide d’optimisation pour l’IA, Google écrit que vous n’avez pas besoin de créer des fichiers texte pour l’IA pour apparaître dans la recherche, y compris ses fonctionnalités d’IA générative, car la recherche Google ne les utilise pas. Créer un llms.txt pour d’autres services est « tout à fait acceptable », mais cela ne vous aidera ni ne vous pénalisera, puisque la recherche Google les ignore.
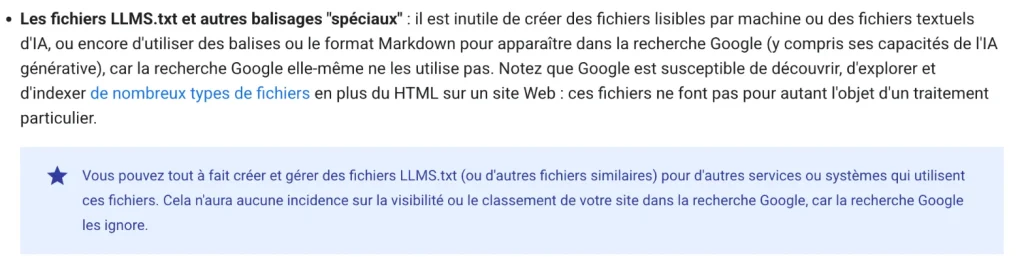
Ses porte-parole disent la même chose depuis 2025 :
- John Mueller a comparé le fichier à la balise meta keywords (avril 2025) : c’est ce que le propriétaire du site affirme de son site, alors qu’on peut aller vérifier le site lui-même. Il ajoutait qu’à sa connaissance, aucun service d’IA n’avait dit l’utiliser.
- Gary Illyes a déclaré en juillet 2025, lors d’un événement Search Central Live, que Google n’avait pas l’intention de le prendre en charge (propos rapportés par des participants).
- Plus récemment, Mueller l’a décrit comme une « béquille temporaire » qui peut faire économiser quelques tokens aux outils de code IA. Pas pour la recherche, donc.
Petite nuance quand même : Chrome Lighthouse a ajouté en 2026 un contrôle llms.txt dans sa catégorie expérimentale « navigation agentique ». Il vérifie surtout que le fichier ne renvoie pas d’erreur serveur, et le considère comme facultatif. Comme le résume Search Engine Journal, cela concerne la préparation aux agents dans le navigateur, pas le classement ni les citations.
OpenAI, Anthropic, Perplexity : ils en publient, sans dire qu’ils les lisent
Ici, le paradoxe est savoureux. Les trois publient un llms.txt pour leur propre documentation développeur. Mais leurs pages officielles sur leurs robots (OpenAI, Perplexity, Anthropic) ne disent nulle part que leurs moteurs utilisent le llms.txt des autres sites pour choisir leurs sources. Ce qu’elles décrivent, c’est le robots.txt.
Autrement dit : aucun de ces éditeurs n’a confirmé publiquement que ChatGPT, Claude ou Perplexity lisent votre llms.txt pour citer votre site. Des SEO ont bien observé des passages de robots d’OpenAI sur ce fichier dans leurs logs, comme Ray Martinez en 2025. Mais un passage n’est pas une preuve d’usage dans les réponses.
Ce que montrent les données 📊
Deux études récentes, avec des méthodes différentes, arrivent à la même conclusion.
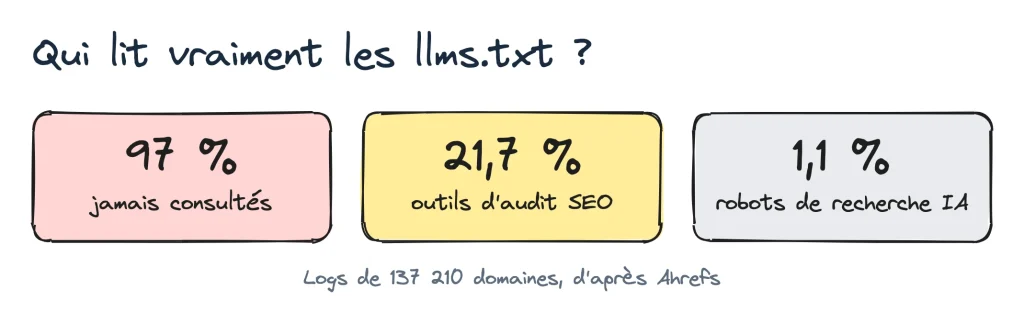
Ahrefs (juin 2026) a analysé les logs de 137 210 domaines en mai 2026. Environ 38 000 publiaient un llms.txt valide, et 97 % de ces fichiers n’ont reçu aucune requête du mois. Les 3 % restants ont reçu environ 22 000 requêtes, venues à 96 % de robots… mais surtout d’outils d’audit SEO (21,7 %) et d’outils de profilage technique, pas d’IA.
Le détail le plus parlant : les robots de recherche IA, ceux qui alimentent les réponses de ChatGPT ou Perplexity, ne pèsent que 1,1 % des requêtes. Les plus assidus sont GPTBot (robot d’entraînement d’OpenAI, 4,51 %) et les agents de code comme Claude Code. Slackbot a même consulté ces fichiers plus souvent que PerplexityBot. Ahrefs précise que chaque chiffre est un plafond : télécharger un fichier ne veut pas dire s’en servir.
SE Ranking (mis à jour en octobre 2026) a croisé la présence d’un llms.txt avec la fréquence de citation dans les réponses IA sur près de 300 000 domaines. Résultat : aucune corrélation mesurable. Retirer la variable « llms.txt » de leur modèle statistique l’a même rendu légèrement plus précis. Les auteurs rappellent que le résultat dépend du modèle et du jeu de données testés.
Seule voix discordante : Mintlify, qui vend un hébergement de documentation générant ces fichiers, affirme d’après des données de Profound que les agents IA consultent deux fois plus le llms-full.txt que le llms.txt, sans publier la méthode. Une donnée d’éditeur, donc, à prendre comme telle.
Mon conseil : avant de croire qui que ce soit, regardez vos propres logs serveur (ou l'outil d'analyse de logs de votre hébergeur). Filtrez les requêtes sur /llms.txt et notez les user-agents. Si vous ne voyez que des outils SEO et quelques curieux, vous avez votre réponse pour votre site.
Pour aller plus loin sur ce sujet, notre sélection des outils d’analyse de logs SEO vous évitera de fouiller les fichiers bruts à la main.
Comment créer un llms.txt en 10 minutes 🛠️
Trois façons de faire, selon votre site :
- Rank Math (gratuit) : activez le module LLMS Txt dans Rank Math SEO › Dashboard, choisissez les contenus à inclure, enregistrez (documentation Rank Math).
- Yoast SEO (gratuit) : Yoast SEO › Réglages › Fonctionnalités du site, rubrique Outils d’IA, activez LLMS.txt (aide Yoast).
- Sans extension : un fichier texte
llms.txten UTF-8, déposé à la racine du site, sur le modèle ci-dessous.
Dans tous les cas, ouvrez ensuite votre-site.fr/llms.txt et relisez-le : pas de page privée, de brouillon ni de page de remerciement.
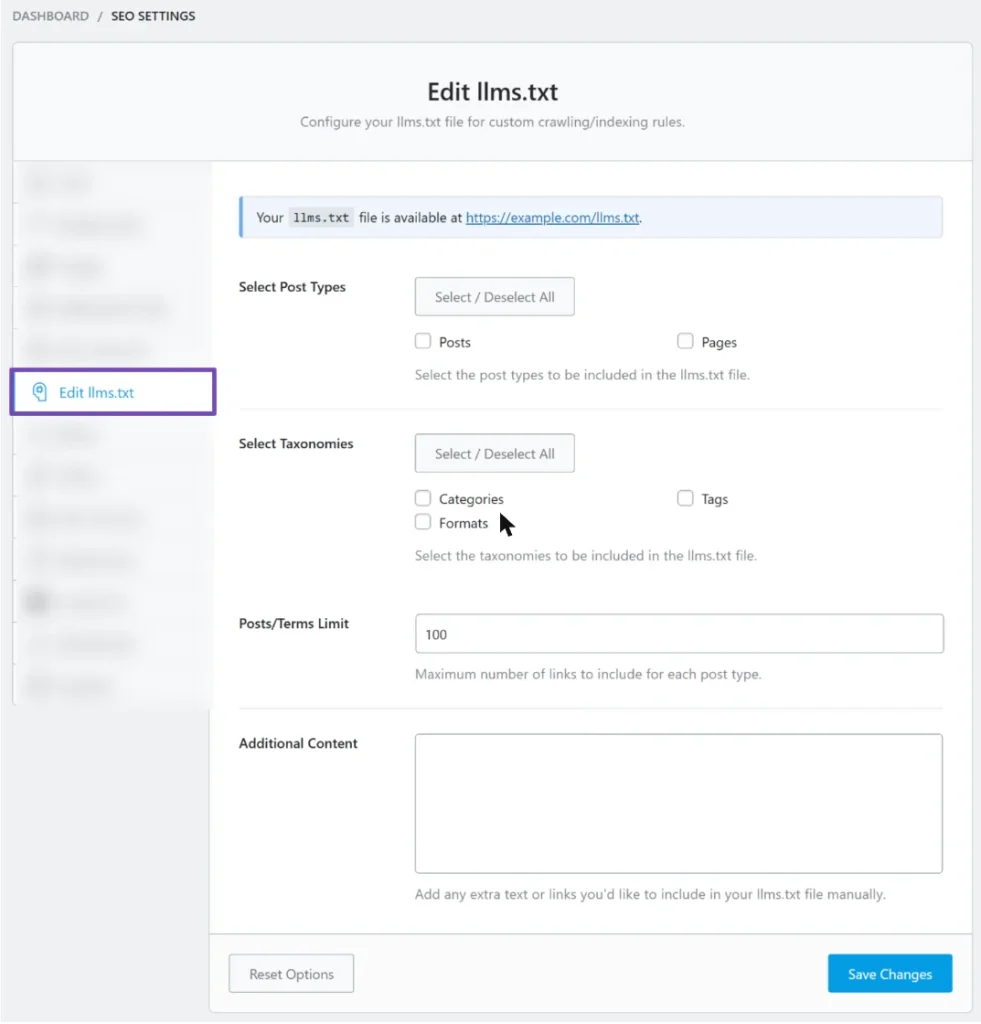
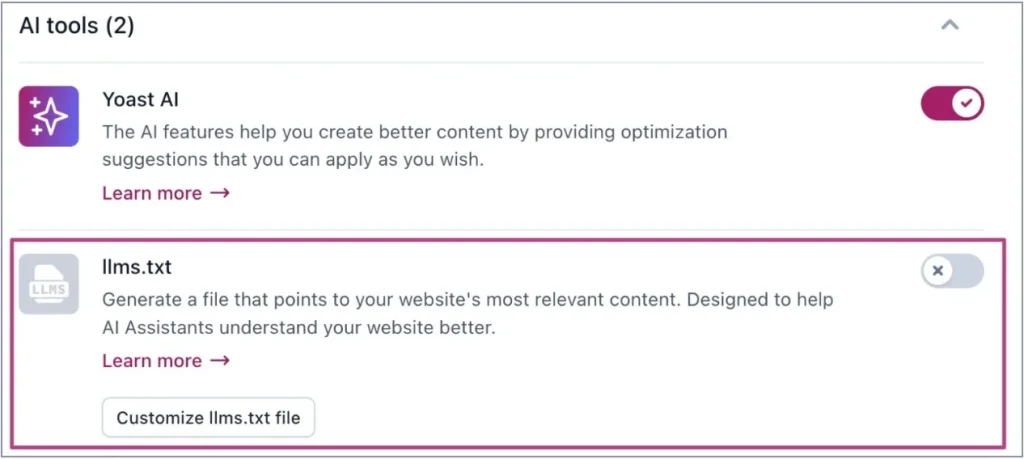
Pour la méthode manuelle, voici un modèle de départ pour un site de PME (à adapter, bien sûr) :
# Nom de votre entreprise

> Boutique en ligne de matériel de randonnée, basée à Lyon. Livraison en France et en Belgique.

Les prix et les stocks à jour sont sur les fiches produits. Pour le service client, utilisez la page Contact.

## Pages principales

- [Catalogue](https://www.votre-site.fr/boutique/): toutes les catégories de produits
- [Livraison et retours](https://www.votre-site.fr/livraison/): délais, tarifs, retours sous 30 jours
- [Guide des tailles](https://www.votre-site.fr/guide-tailles/): correspondances par marque

## Guides

- [Choisir ses chaussures de randonnée](https://www.votre-site.fr/blog/choisir-chaussures/): les critères selon le terrain

## Optional

- [Mentions légales](https://www.votre-site.fr/mentions-legales/)
Mon conseil : si vous utilisez Rank Math, n'activez pas en plus la fonction de Yoast (et inversement). Yoast écrit un vrai fichier à la racine du site, alors que Rank Math le génère à la volée : un fichier physique passe généralement avant la version générée, et vous ne savez plus lequel vous servez.
Les erreurs fréquentes avec le llms.txt 🚫
- Y voir un levier SEO. C’est l’erreur n° 1. Google dit l’ignorer, et les études ne montrent aucun effet sur les citations IA.
- Le confondre avec le robots.txt. Le llms.txt ne bloque aucun robot. Pour refuser l’entraînement ou autoriser la recherche IA, c’est dans le robots.txt que ça se passe.
- Tout y mettre. Un llms.txt de 500 liens perd tout son intérêt de « plan ». Sélectionnez vos pages les plus utiles et commentez chaque lien en une phrase.
- Activer la génération automatique sans relire. Les extensions reprennent souvent le début de chaque article, accroches comprises, et peuvent ignorer des types de contenus entiers (fiches produits, pages personnalisées).
- Laisser passer des pages qui n’ont rien à faire là. Pages de remerciement, contenus obsolètes, pages tests : relisez le fichier généré, surtout en mode automatique.
- Glisser des consignes aux IA. Ahrefs a repéré un robot d’étude qui analysait ces fichiers sous l’angle de l’injection de prompt. Traitez votre llms.txt comme du code : uniquement des informations factuelles, aucun texte que vous n’assumeriez pas en public.
- L’oublier. Un fichier manuel qui pointe vers des pages supprimées envoie les agents dans le mur. Si vous le faites à la main, notez une relecture trimestrielle.
Pour aller plus loin
- Le cadre complet pour être cité par les moteurs IA : notre guide du GEO.
- Pour comprendre les agents qui lisent ce type de fichier : le guide de l’agent IA.
- Tous nos articles de la rubrique SEO.
Questions fréquentes
Le llms.txt améliore-t-il le référencement Google ?
Non. Google indique dans sa documentation officielle que sa recherche ignore les fichiers llms.txt, y compris pour les Aperçus IA et le Mode IA. Le fichier ne vous aidera ni ne vous pénalisera dans Google.
ChatGPT lit-il le fichier llms.txt ?
OpenAI n’a jamais confirmé publiquement que ChatGPT utilise le llms.txt des sites pour choisir ses sources. Selon Ahrefs, GPTBot, le robot d’entraînement d’OpenAI, est le robot IA qui le télécharge le plus, mais les robots de recherche IA ne représentent qu’environ 1 % des requêtes observées.
Quelle différence entre llms.txt et llms-full.txt ?
Le llms.txt est un index court qui résume le site et pointe vers ses pages utiles. Le llms-full.txt, une convention lancée par Mintlify et non prévue par la spécification officielle, regroupe tout le contenu d’une documentation dans un seul fichier, parfois de plusieurs dizaines de mégaoctets. Pour un site de PME, le llms.txt seul suffit largement.
Où placer le fichier llms.txt ?
À la racine du site, à l’adresse votre-site.fr/llms.txt, en texte brut. La version 2 de la proposition autorise aussi un fichier dans un sous-dossier (par exemple /docs/llms.txt), qui ne couvre alors que les pages de ce dossier. Avec Rank Math ou Yoast, l’emplacement est géré automatiquement.